Le point de départ est presque toujours le même
Une entreprise commence rarement avec une base de données. Elle commence avec un tableur, parce qu'un tableur est immédiat, gratuit et compris par tout le monde. C'est un excellent point de départ, et il n'y a rien à lui reprocher tant que l'activité tient dans un seul fichier ouvert par une seule personne.
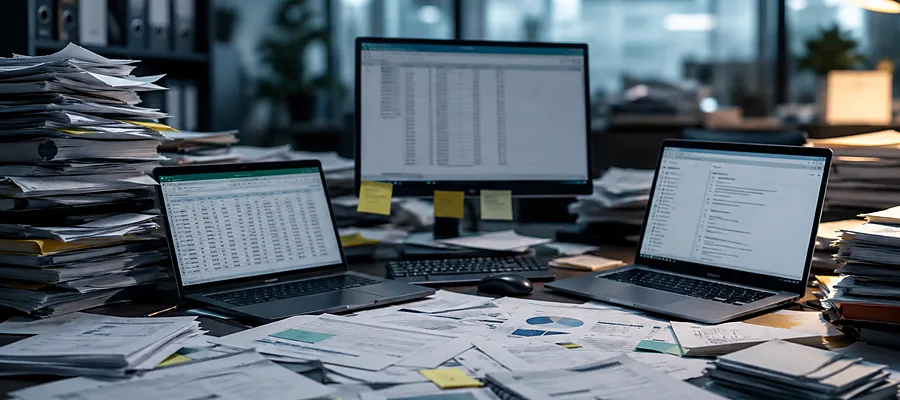
Le basculement se produit sans qu'on le remarque. Un deuxième fichier apparaît pour le suivi commercial. Un troisième pour les stocks. La comptabilité tient le sien. Le service client note ses échanges ailleurs. Chacun de ces fichiers est utile et à jour dans son coin. Le problème n'est jamais un fichier en particulier, c'est ce qui se passe entre eux.
Une enquête relayée par LeMagIT montre que 53 % des entreprises interrogées traitent leurs données dans un tableur, et que seulement 21 % manipulent de véritables outils d'analyse. La dispersion n'est donc pas une exception, c'est la situation la plus répandue.
Trois choses se perdent en même temps
Du temps, et il ne se voit pas
Chaque question qui traverse plusieurs fichiers demande une compilation manuelle. Combien de clients actifs dans telle région, quel encours par commercial, quels dossiers sans nouvelle depuis un mois. Une base de données répond en quelques secondes. Un ensemble de fichiers séparés demande une demi-journée à quelqu'un, et cette demi-journée ne figure sur aucune ligne budgétaire.
De la fiabilité, à chaque ressaisie
Une donnée saisie deux fois est une erreur en puissance. Un numéro de téléphone mis à jour dans le fichier commercial mais pas dans le fichier de facturation, une adresse corrigée d'un côté seulement, un nom orthographié de deux manières. Rien de tout cela ne déclenche d'alerte. L'erreur reste silencieuse jusqu'au jour où elle produit une facture qui n'arrive pas, une relance envoyée à un client déjà payé, une livraison à l'ancienne adresse.
De la vision, faute de consolidation
Tant que les informations ne se rejoignent pas, personne ne dispose d'une image d'ensemble. On pilote sur des extraits, chacun exact dans son périmètre et incomplet à l'échelle de l'entreprise.
Les vérités concurrentes
C'est le symptôme le plus révélateur. Le chiffre d'affaires du commercial ne correspond pas à celui de la comptabilité. Le stock théorique ne correspond pas à l'entrepôt. Le nombre de clients dépend de qui répond à la question.
Aucun de ces chiffres n'est faux. Ils reposent simplement sur des périmètres, des dates d'extraction et des règles de calcul différentes. Mais quand deux chiffres cohabitent sur le même sujet, la réunion cesse de porter sur la décision à prendre et se met à porter sur le chiffre à retenir. C'est du temps de direction consommé par un problème d'organisation de l'information.
Ce que le désordre coûte, quand on le mesure
Gartner estime la perte moyenne liée à une donnée de mauvaise qualité à plusieurs millions par an pour une grande organisation, répartie entre du travail refait, des opportunités manquées et des décisions prises sur des bases fausses. L'ordre de grandeur ne se transpose pas tel quel à une PME, mais un constat de cette étude s'y applique intégralement : environ 60 % des organisations ne mesurent pas ce coût. Elles le subissent sans le voir.
Dans l'industrie, les coûts de non-qualité, qui incluent les erreurs de données, sont couramment évalués entre 5 et 15 % du chiffre d'affaires. Là encore, l'important n'est pas le pourcentage exact, c'est qu'il s'agit d'un poste réel, absorbé dans le fonctionnement courant, jamais isolé sur une facture.
Le moment où le problème devient visible
Certains signaux ne trompent pas :
- Une même information existe à plusieurs endroits et personne ne sait laquelle fait foi
- Produire un chiffre simple demande de solliciter deux ou trois personnes
- Un fichier porte un nom qui se termine par final, puis final_v2
- Un départ dans l'équipe fait disparaître la connaissance d'un fichier
- Personne ne sait dire depuis quand une donnée est là ni qui l'a modifiée
- Répondre à un client sur son historique demande de chercher dans plusieurs outils
Le dernier point est celui qui se voit de l'extérieur. Les autres restent internes, et c'est pour cela qu'on s'en accommode longtemps.
Ce que la centralisation change
Rassembler les informations dans une base structurée ne consiste pas à remplacer un outil par un autre. Cela consiste à décider qu'une information n'existe qu'à un seul endroit, que les autres outils viennent la lire plutôt que la recopier, et que toute modification y laisse une trace.
À partir de là, les trois pertes s'inversent. Le temps de compilation disparaît puisque la question s'adresse directement à la source. La fiabilité augmente puisque la donnée n'est saisie qu'une fois. La vision d'ensemble devient possible puisque tout se rejoint.
Ce qu'il faut retenir
Le désordre des données ne provoque pas de panne. Il ne déclenche aucune alerte et n'apparaît dans aucun rapport. Il produit de la lenteur, des approximations et des désaccords internes, trois choses qu'on attribue généralement à autre chose.
La question utile n'est pas de savoir si vos données sont parfaitement rangées, elles ne le sont jamais complètement. Elle est de savoir combien de fois par semaine votre équipe cherche une information qui devrait être immédiate, et si vous seriez capable de dire, aujourd'hui, laquelle de vos sources fait autorité.